从 Desmos 到 CaLU:我的激活函数折腾手记 (I)
说明一下分工:灵感、猜想都是我的;代码和实验是 AI 写的,我只负责动嘴和动念头和训练。
前几天三角函数复习累了,在 Desmos 上拖曲线玩,把 arctan 和 tanh 画到一张图里,越看越觉得它俩长得像——都是 S 形,都是两边饱和。区别无非是 $\tanh$ 值域是 $(-1, 1)$,$\arctan$ 是 $(-\frac{\pi}{2}, \frac{\pi}{2})$,横竖缩放一下就能重合。
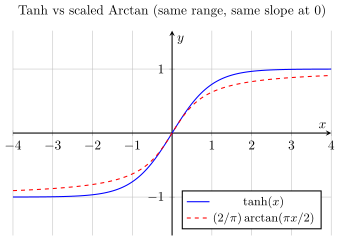
那一刻冒出个念头:arctan 缩一缩能不能直接当激活函数?
但这个念头只活了三秒。因为答案是显而易见的:肯定不好。tanh 和 sigmoid 当年在深网里怎么死的,arctan 就得怎么死——两边饱和,导数 $\frac{1}{1+x^2}$ 往两边一滑就没了,层数一深梯度直接消失。这都不用跑实验,算一下导数上确界就知道。所以 arctan 原教旨主义当场放弃。
但 Desmos 还开着,我就多看了两眼。顺手把 sigmoid 画了一下
关于 Swish 的那个”坑”
视线移到 Swish 身上:$f(x) = x\cdot\sigma(x)$。这条曲线的左半边有个很有名的小坑——$x\approx -1.28$ 处 dip 到 $-0.28$ 再爬回来。大家都说这个非单调的坑是 Swish 好用的原因之一,但我当时犯轴:如果我偏要把它掰直呢?
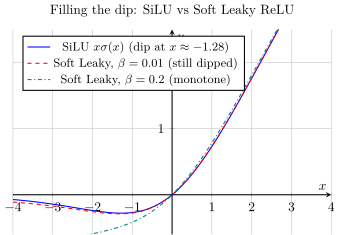
最顺手的办法就是加一个 x term 进去,搞成漏的(leaky):
\[f(x) = (1-\beta)\cdot x\cdot\sigma(x) + \beta\cdot x\]$x\to +\infty$ 时趋近于 $x$,$x\to -\infty$ 时趋近于 $\beta\cdot x$——这不就是 Leaky ReLU 被磨光滑了吗?我给它起名叫 soft leaky relu。
然后直接在 Desmos上看一下单调性。当 $\beta$ 取 $0.2$ 是稳单调的,$\beta$ 取 $0.01$ 则还留着那个坑。算了一下单调性。$f’(x) = (1-\beta)\cdot[\text{SiLU 的导数}] + \beta$,而 SiLU 导数在 $x\approx -2.40$ 处有个最小值 $-0.0998$。令最小导数大于零,解出来 $\beta > 0.0908$ 时函数严格单调。
这个 $0.09$ 的阈值后来变得很有意思——先按下不表。
sigmoid—tanh—arctan:为什么不魔改门控?
soft leaky relu 写出来之后,我盯着它看了很久,结构是 $x\cdot\mathrm{gate}(x) + \mathrm{leak}$。门控现在是 sigmoid,但我的联想链是这样的:
sigmoid 和 tanh 是亲戚($\tanh(x) = 2\sigma(2x) - 1$,小学二年级知识),tanh 和 arctan 长得像(Desmos 告诉我的)——那为什么不把 arctan 魔改成门控,塞进同一个模板里试试?
当时写下的原式是这样的:
\[\begin{align} T(x) &= \frac{\arctan(x)}{\pi/2} \\ t(x) &= \frac{T(x)+1}{2} \\ a(x) &= (1-\beta)\cdot x\cdot t(x) + \beta\cdot x \end{align}\]$T$ 把 $\arctan$ 压到 $(-1, 1)$,$t$ 再搬到 $(0, 1)$,正好是个门控。写完之后我随手把式子丢给 AI 看,它一眼就认了出来:$\frac{1}{2}\left(\frac{2\arctan(x)}{\pi}+1\right)$,这不就是……标准 Cauchy 分布的 CDF 吗?$C(x) = \frac{1}{2} + \frac{1}{\pi}\arctan(x)$,一模一样。
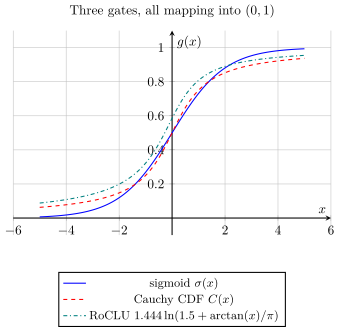
顺着这个提示,swish、gelu 全连起来了:
- Logistic CDF → SiLU/Swish
- Gaussian CDF → GELU
- Cauchy CDF → ???空着呢
$x\cdot\mathrm{CDF}(x)$ 三位一体,缺的那块拼图长这样。名字是写代码的 AI 起的:CaLU(Cauchy Linear Unit),完整版叫 Leaky CaLU——跟 SiLU、GELU 正好一家人,我拍板用了。门控零点斜率也排得整整齐齐:Gaussian $0.399$ > Cauchy $0.318$ > Logistic $0.25$,Cauchy 恰好卡在中间——尾部最重、开启居中,对称得很漂亮。
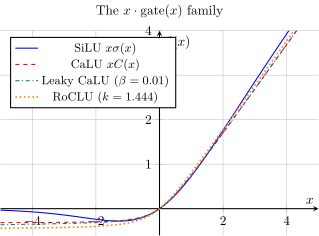
名字起完去搜文献,心凉了半截又热了起来:一篇 2026 年 9 月 3 号的论文,Küçükali 等人的 RoCLU(Robust Cauchy Linear Unit),公式是 $1.444\cdot x\cdot \ln\left(1.5 + \frac{\arctan(x)}{\pi}\right)$——同一个 $x\cdot g(\arctan(x))$ 家族,门控是个 log 变换。
转念一想,这是好事:第一,说明 Cauchy 门这条路不是我一个人在走,方向大概率没错;第二,人家的门和我的门不一样(log 门 vs 精确 CDF 门),叙事不打架;第三,现成的文献基线,白捡的。果断把它加进对比里一起跑。
实验:跑了 45 次,只看结果
实验设计很简单,核心思想就一句话:把模型变瘦,差距自然现形。经典 LeNet 在 MNIST 上闭眼 99%,什么激活函数都一个样——所以故意把网络阉割到 $5.4\text{k}$ 参数(约为原版的 $\frac{1}{10}$),无 BN、无 Dropout、只训 $10$ 个 epoch。模型长这样($28\times28$ 输入):
| # | 层 | 配置 | 输出尺寸 | 参数量 |
|---|---|---|---|---|
| 1 | Conv1 + Act | $1{\to}4$ 通道,$5{\times}5$ | $4\times24\times24$ | 104 |
| 2 | AvgPool | $2{\times}2$ | $4\times12\times12$ | 0 |
| 3 | Conv2 + Act | $4{\to}8$ 通道,$5{\times}5$ | $8\times8\times8$ | 808 |
| 4 | AvgPool | $2{\times}2$ | $8\times4\times4$ | 0 |
| 5 | Flatten | — | $128$ | 0 |
| 6 | FC1 + Act | $128{\to}32$ | $32$ | 4128 |
| 7 | FC2(无激活) | $32{\to}10$ | $10$(logits) | 330 |
| 合计 | 5370 |
11 个激活函数,除了 Act 里装的东西不一样,其他严格同构:同一套 Xavier 初始化、同一个优化器(Adam,$\text{lr}=10^{-3}$,$\text{weight decay}=0$,无 scheduler)、同一个 batch size($512$)、同一个 device(mps),每个激活跑 3 个 seed。代码是 AI 搞的,我就给了超参数和 exp 编号对照表,然后训练。
主结果(MNIST 测试集,3-seed 均值 $\pm$ std,单位 %)
| 激活 | seed0 | seed1 | seed2 | 均值 |
|---|---|---|---|---|
| Soft Leaky ReLU | 97.78 | 97.39 | 97.82 | $97.66 \pm 0.24$ |
| SiLU | 97.67 | 97.38 | 97.83 | $97.63 \pm 0.23$ |
| GELU | 97.58 | 97.54 | 97.71 | $97.61 \pm 0.09$ |
| RoCLU | 97.90 | 97.04 | 97.69 | $97.54 \pm 0.45$ |
| Tanh | 97.53 | 97.67 | 97.37 | $97.52 \pm 0.15$ |
| Leaky CaLU | 97.75 | 97.17 | 97.60 | $97.51 \pm 0.30$ |
| CaLU | 97.76 | 97.12 | 97.60 | $97.49 \pm 0.33$ |
| Arctan | 97.40 | 97.70 | 97.21 | $97.44 \pm 0.25$ |
| Leaky ReLU | 97.54 | 97.55 | 97.15 | $97.41 \pm 0.23$ |
| ReLU | 97.52 | 97.53 | 97.15 | $97.40 \pm 0.22$ |
| Sigmoid | 90.66 | 94.33 | 90.30 | $91.76 \pm 2.23$ |
SiLU($97.63$)> GELU($97.61$)> CaLU($97.49$)GELU 方差全场最小($\pm 0.09$)、首 epoch 启动最快($90.17$),高斯门不愧是工业界千锤百炼的选择,稳得可怕。RoCLU 排第四,还拿了全场最高单次 $97.90$,但方差也是除 sigmoid 外最大的。sigmoid 垫底不意外:首 epoch 只有 $43.7\%$,梯度消失的教科书现场。
门控 $\times$ leak
把四个”自己人”单独拎出来,门控(sigmoid 门 vs Cauchy 门)$\times$ leak($\beta=0$ vs $\beta=0.01$)正好组成对照:
| 均值 | $\beta=0$ | $\beta=0.01$ |
|---|---|---|
| sigmoid 门 | SiLU 97.63 | Soft 97.66 |
| Cauchy 门 | CaLU 97.49 | LeakyCaLU 97.51 |
leak 效应两行都是 $+0.02\sim0.03$,门控效应两列都是 sigmoid 门 $+0.14\sim0.15$——方向完全一致,可惜幅度都在噪声带里。RoCLU(log 门)以 $97.54$ 落在两者之间,恰好对应它的门控形状也居中($g’(0)\approx 0.306$,负半轴渐近值比 Cauchy 更深:$-0.46$ vs $-0.32$)。而三位一体内部 SiLU > GELU > CaLU,恰好是门控开启锐度的反序。但说实话,除 sigmoid 外大家差距都在噪声带里,显著性不够。
最有意思的:β 消融 vs 单调阈值
前面在 Desmos 上算过,soft leaky relu 的导数是
\[f'(x) = (1-\beta)\,[\sigma(x) + x\sigma(x)(1-\sigma(x))] + \beta\]方括号里是 SiLU 的导数,最小值约 $-0.0998$($x\approx -2.40$ 处)。令它大于零:
\[(1-\beta)(-0.0998) + \beta > 0 \quad\Longrightarrow\quad \beta > \beta^* \approx 0.0908\]所以 $\beta=0.2$ 稳单调,$\beta=0.1$ 擦边单调(最小导数 $0.01$),$\beta=0.01$ 不单调(还留着坑)。而我做了四档实验,把 $\beta$ 从 $0.01$ 放大到 $0.3$:
| $\beta$ | 最终精度(均值$\pm$std) | epoch1 均值 | 单调性(最小导数) |
|---|---|---|---|
| 0.01 | $97.66\pm0.24$ | 89.92 | 不单调($-0.089$,留坑) |
| 0.1 | $97.47\pm0.44$ | 88.99 | 擦边单调($+0.010$) |
| 0.2 | $97.36\pm0.46$ | 88.02 | 稳单调($+0.120$) |
| 0.3 | $97.00\pm0.41$ | 87.30 | 稳单调($+0.230$) |
均值和启动速度两个维度严格单调下降,方差整体放大($\pm0.24\to\pm0.41$,中间 $\beta=0.2$ 档最高 $\pm0.46$)。也就是说,单调的版本反而更差。那个坑,在浅网 MNIST 上至少不是坏事。我当初”把它掰直”的执念,被自己的实验否了。科学就是这样,猜想负责貌美如花,数据负责铁面无私。
下一步:VGG
我的直觉是:Cauchy 门这种重尾、多项式拖尾的设计,在只有 3 个非线性层的简化 LeNet 里根本施展不开,因为门控的这种差异要连乘 8~10 次才会复利放大。下图是原因:sigmoid 门的 $1-g(x)$ 是指数衰减(半对数坐标下呈直线),三下五除二就饱和到底;而 Cauchy 门和 RoCLU 门是多项式拖尾,软得很久。层数一深,前者早早”决断”,后者还留着梯度(VGG 这种无 BN 的深网才是它的主场)。RoCLU 那篇论文也是往深了测(最深到 700 层)。
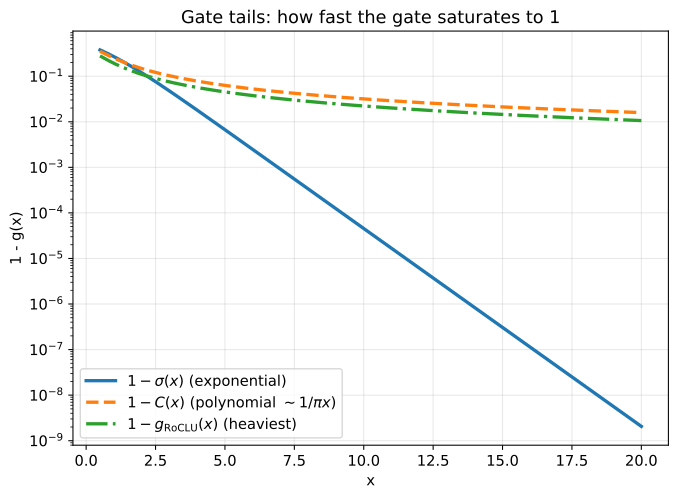
所以后面:VGG + CIFAR-10。门控三家(sigmoid / Cauchy-CDF / log)到底谁在深水区更能打,敬请期待下篇。
完整实验报告、45 次训练的原始实验结果见存档(calu-archive.zip,共 42 个实验目录:11 个激活,3 seed,33 个主实验,另 9 个为 β 消融新增;β=0.01 一档复用主实验。解包后运行 collect_results.py / beta_ablation.py 即可复现全部图表),欢迎拍砖。CaLU 的名字要是跟谁撞了也请告诉我——截至动笔那天,我只查到 RoCLU 这一个亲戚。
参考文献
[1] Küçükali Ö, Bozkurt MH, Ulutaş E, Bozkurt I. A Novel Activation Function for Enhancing Deep Neural Network Stability and Performance. Concurrency and Computation: Practice and Experience. 2026;38:e70944. DOI: 10.1002/cpe.70944.